お名前:ゆうい
現在:AIウォッチャー・リサーチャー
AI関連の情報を探し回っては、
時には試したり、時には深堀したりしています。
基本スタンスは「技術をなぞる」ことであり、極力「わからない」から来る心のモヤモヤを消すために日々技術調査なんぞをしています。
AIの中身を知ることで、よりよく出来るところはまだ残っている、それをベースにこれまで培った技術をベースにしたテクニカルライティング業務をとある企業様向けに行っています。時々そんな技術ブログの執筆なども行っています。
実績(2022年-2026年:AI/DeepLearning関連のみ)
- Whisperベースのカスタマイズモデルファインチューニング(手動学習率セットを使用したFinetune)
- llama.cppを使用したローカルLLMサービス公開
- GRPO+UnslothによるPHI-4ファインチューニング
- SFT+LoRAによるGemma-2ファインチューニング
ハンデキャップ
重症筋無力症(2018-)/ASD+ADHD(2017-)/性別不合(2023-)
身体障害者手帳2種4級所持(下肢不自由:2019-)
歩行困難なため、杖が欠かせませんです
私のスローガン。
「すべては、わたしを頼ってくださる数少ない人達のために」
私が取り組む者は所謂「ニッチな部分」でしかなくて。殆どの人が興味を持たない領域。そして使い古された技術と既に通り過ぎた何か。そんなものでも参考にして何かに役立ててくれる人が居るのなら、ここで紡いでいこうと思っています。
興味のある分野
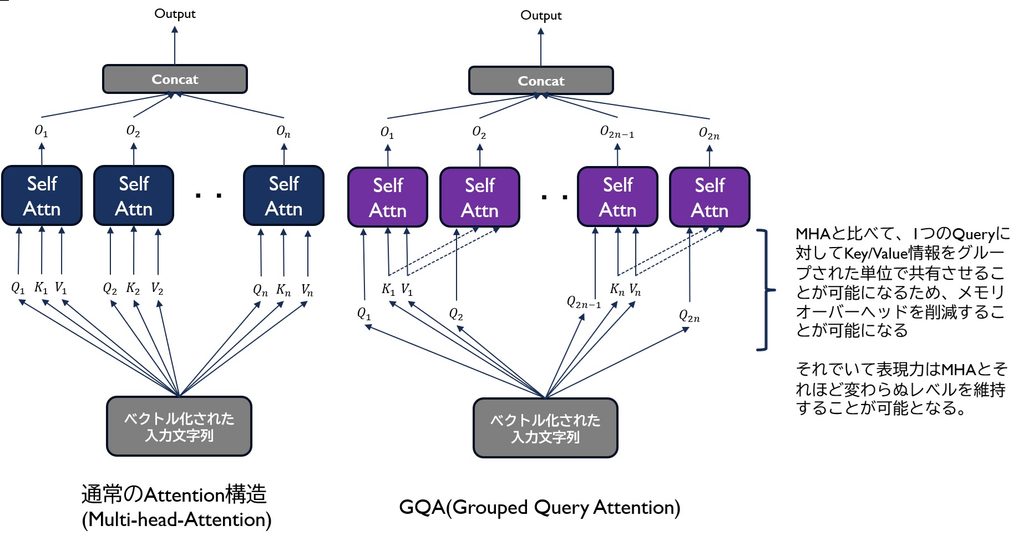
モデル構造に興味があり、日々情報をウォッチしています。その一つ一つの関数まで完全に理解するには至りませんが、そのモデルのどんなところが増強されたのか、そこにはどんな考え方があってそうなっているのかを掘って掘って掘りまくってます。例えば、下図はアテンション構造でも代表的なGQAというものが、Multi-head-Attention(MHA)から動きを変えたのか、少し違う観点で表現した図です。
基礎検証環境
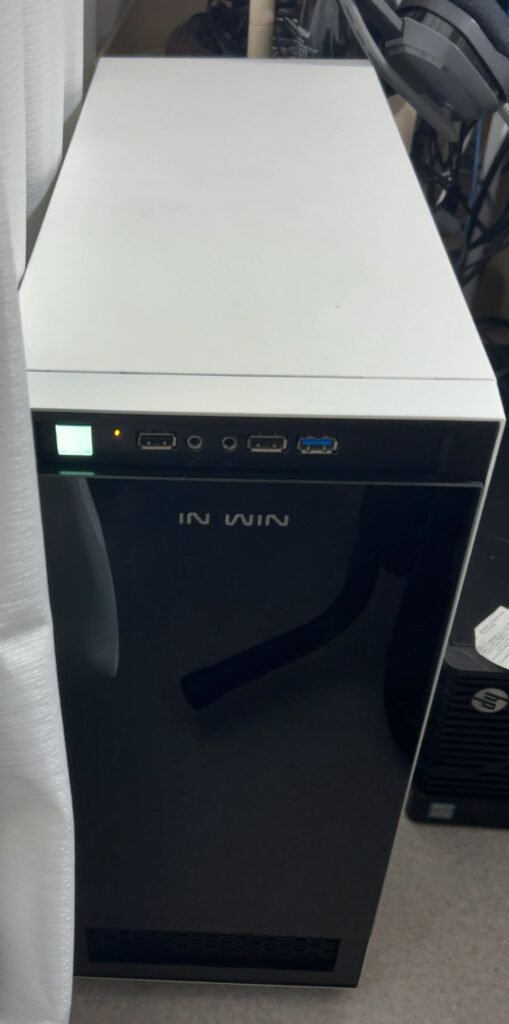
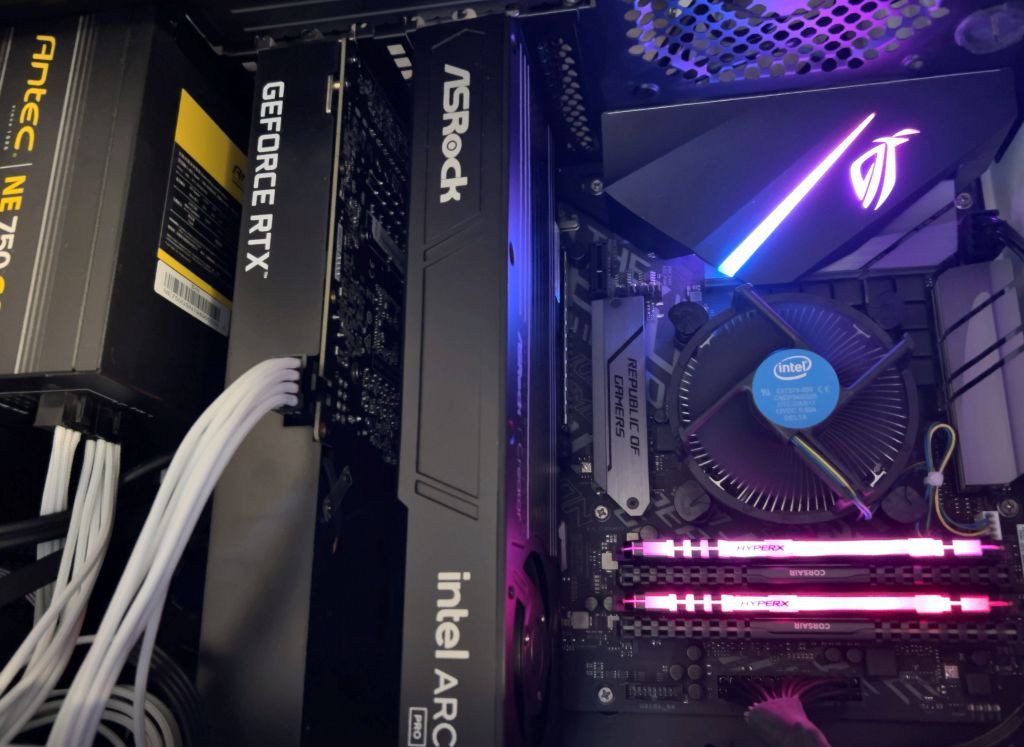
基礎検証(基本的な動作確認、活動のために必要なサービス動作)を行う環境として以下の環境を使用しています。いろいろなものが高くつく時代になりましたね・・
| 項目 | 品名など |
|---|---|
| 機種 | 中古自作PC |
| CPU | Intel(R) Core i7-9700(4C/8T) |
| RAM | 48GB DDR4 SDRAM |
| Storage | Intel DC S3700 SATA SSD (400GB) WD WDS200T2BOA SATA SSD (2000GB) |
| GPU | NVIDIA GeForce RTX 3060 (Ampere/VRAM 12GB) Intel ARC PRO B70 (BattleImage/VRAM 32GB) |
| OS | Ubuntu 24.04 LTS + Kernel 6.17.0-42 |
| board | ASUS ROG STRIX H370-F GAMING |
| PWR | Antec NE 750 GOLD |
| Case | IN WIN 530 (ATX PC Case) |
GPU詳細スペック比較表
| 項目 | GeForce RTX 3050 (8GB) | GeForce RTX 3060 (12GB) | Intel ARC PRO B70 |
| 基本アーキテクチャ | Ampere | Ampere | BattleImage |
| CUDAコア数 | 2,560 | 3,584 | 4,096 |
| Tensorコア数 | 80 | 112 | 256(XMX) |
| レイトレーシングコア数 | 20 | 28 | 32 |
| INT4演算性能 (理論値) | 約 145.6 TOPS | 約 203.8 TOPS | 約 734.0 TOPS |
| FP32演算性能 (理論値) | 約 9.1 TFLOPS | 約 12.7 TFLOPS | 約 22.94 TFLOPS |
| ビデオメモリ (VRAM) | 8 GB GDDR6 | 12 GB GDDR6 | 32 GB GDDR6 |
| メモリバス幅 | 128-bit | 192-bit | 256-bit |
| メモリバス帯域 | 約 224 GB/s | 約 360 GB/s | 約 608 GB/s |
| 消費電力 (TDP) | 130W | 170W | 250W(Limit) |
| Tensorコア対応データ型 | FP32, FP16, BF16, INT8, TF32 | TF32, FP16, BF16, INT8, INT4, INT2 | |
※FP32演算性能およびコア数は、標準的なモデルに基づいた近似値です。
我が家で動いてる推論基盤
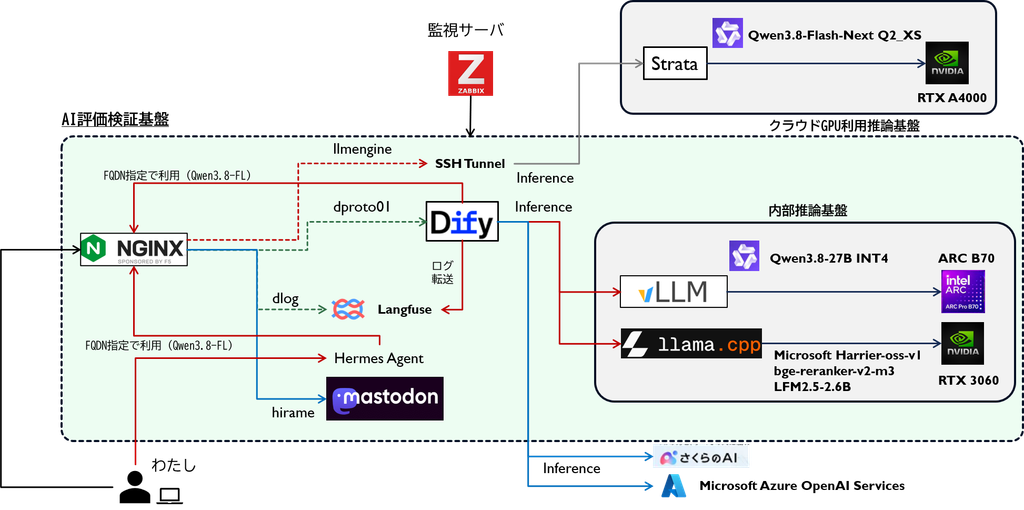
我が家はDifyのWebAppをフロントエンドに、llama.cppを使ったMeta Muse GlimmerモデルをChatモデルに、そのほかEmbeddingモデル・Rerankモデルを使った推論基盤があり、Difyのバックエンドとして動いています。ナレッジベースを持ち、そこに見つけた興味ある論文草稿を必要な時に適宜放り込んでいます。