
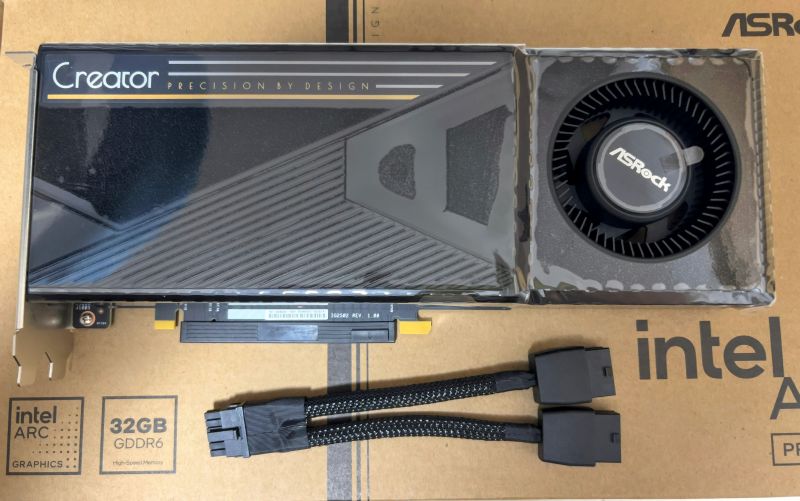
Intel ARC PRO B70で学習処理を
Intel ARC Pro B70で学習処理をしたいと思うものの、CUDAは経験あるもののIntelのGPUだとどうなんだろう?と思って取り組んだのが本記事。すぐ忘れそうだったので、今回は備忘録として記載。
実行する際に必要なもの
XPUの場合は、bitandbytes を用いて4bitのQLoRAが可能な上、INT8演算も可能ってことが分かっているので、これらを使って処理を書くことになります。INT8に対応しているから、オプティマイザに 8bit-PagedAdam も使えますと。
実行に必要なものは以下の通りでした。
# 必須: Intel GPU ドライバを最新版に更新しておく(Windows/Linux とも)
pip install --upgrade pip

# PyTorch XPU 版(安定版)
pip install torch --index-url https://download.pytorch.org/whl/xpu

# SFT 用ライブラリ
pip install transformers trl datasets peft accelerate実行コード
実行コードは以下の通りでした。試しにQwen2.5-7Bを訳も分からずCapybaraデータセットでチューニングしていますが、動作確認目的なのでご容赦を。
どうやらすっごく回りくどい理由で fp16 が使えないみたい。原則 bf16 で計算するようにとのことです。(Powered by Qwen3.8-FN and GPT-6-Luna)
また、私の環境、実はCUDAデバイス(RTX-3050)が同居しているため、これを明示的に排除する必要があります。そのために行ったのが CUDA_VISIBLE_DEVICES 環境変数を空にすること。これをしないとCUDAデバイスも反応してエラーになるので混在環境の際は留意してください。
import os
os.environ.setdefault("ACCELERATE_TORCH_DEVICE", "xpu")  # accelerate/transformers のデバイス強制[S9][S10]
os.environ.setdefault("CUDA_VISIBLE_DEVICES", "")         # CUDAデバイス併用を避けるため、不可視にする

import torch
from datasets import load_dataset
from transformers import AutoModelForCausalLM, AutoTokenizer, BitsAndBytesConfig
from peft import LoraConfig, prepare_model_for_kbit_training
from trl import SFTConfig, SFTTrainer

MODEL_ID = "Qwen/Qwen2.5-7B"      # 32GB なら 7B クラスも狙える
DATASET_ID = "trl-lib/Capybara"
OUTPUT_DIR = "outputs/qlora-xpu"

bnb_config = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_quant_type="nf4",
    bnb_4bit_compute_dtype=torch.bfloat16,   # XPU は bf16 を使う[S1]
    bnb_4bit_use_double_quant=False,         # XPU で二重量子化が通るか未確認なので最初は切る
)

tokenizer = AutoTokenizer.from_pretrained(MODEL_ID)
model = AutoModelForCausalLM.from_pretrained(
    MODEL_ID,
    quantization_config=bnb_config,
    device_map="xpu",            # IPEX の int4 例も device_map="xpu" を使う[S15]
    attn_implementation="eager",
)
# 4bit + gradient checkpointing の併用に入力勾配が必要
model.enable_input_require_grads()
model = prepare_model_for_kbit_training(model, use_gradient_checkpointing=True)

# データセット取り込み
raw = load_dataset(DATASET_ID, split="train")

# テンプレートへの適用(ChatCompletion形式で書込み)
def to_messages(ex):
    if "messages" in ex:
        return {"messages": ex["messages"]}
    return {"messages": [
        {"role": "user", "content": ex["prompt"]},
        {"role": "assistant", "content": ex["completion"]},
    ]}

dataset = raw.map(to_messages, remove_columns=raw.column_names, num_proc=4)

peft_config = LoraConfig(
    r=256, lora_alpha=512, lora_dropout=0.05, bias="none",                          # LoRA設定(Rank高めに設定)
    task_type="CAUSAL_LM",                                                          # 因果モデルに対する学習
    target_modules=["q_proj", "k_proj", "v_proj", "o_proj","up_proj","down_proj"],  # 学習対象
)

training_args = SFTConfig(
    output_dir=OUTPUT_DIR,
    num_train_epochs=1,             # 学習エポック数
    per_device_train_batch_size=2,  # バッチサイズ
    gradient_accumulation_steps=8,  # ステップ統合
    optim="paged_adamw_8bit",   # メモリ節約
    learning_rate=2.0e-4,
    max_length=1024,
    bf16=True, fp16=False,      # fp16は使用せず、bf16のみとする
    gradient_checkpointing=True,
    gradient_checkpointing_kwargs={"use_reentrant": False},
    logging_steps=10,           # ログ感覚
    report_to="none",
    dataloader_num_workers=0,
    dataset_num_proc=4,         # データ処理セットプロセス数
    completion_only_loss=True,
)

trainer = SFTTrainer(
    model=model,                    # モデル
    args=training_args,             # Configパラメタ
    train_dataset=dataset,          # データセット
    peft_config=peft_config,        # 量子化設定
    processing_class=tokenizer,     # トークナイザ
)
trainer.train()
trainer.save_model(f"{OUTPUT_DIR}/final")
tokenizer.save_pretrained(f"{OUTPUT_DIR}/final")リソース負荷
今回のこの7Bモデルが、そのまま16bitでチューニングすると15GiB程度あるんですが、こっから量子化を行うと、4bitの場合およそ 3.75 GiB となります。そこからさらに 1024 トークンを上限にファインチューニングをさせたときのメモリ消費量はおよそ 14 GiB を記録してましたので、それなりのリソース消費がファインチューニングで発生するようです。差分で考えるとおよそ 10 GiB ぐらいはチューニングに使うという感じですネ。
今回 Qwen3.5-9B もしくは Qwen3.5-4B で何かチューニングを試してみたかったりするので、そのために色々勉強してみようかなと思ったりするのでした。
コメント