
待ちわびた人もそれなりにいるはず
さくらのAI Engineに新しい2モデルが追加されました。Public Preview扱いとなっています。
各モデルについてザックリ書くとこんな感じです。
- GLM-5.3-Flash
- 総パラメータ約320B(アクティブ18B)のMoE(Mixture of Experts)大規模言語モデル
- 最大コンテキスト長 1M Tokens
- 入力課金:0.40 JPY/10KToks
- 出力課金:4.00 JPY/10KToks
- DeepSeek-V4.1-Flash-1017
- Causal Encoder-Decoder(CED)ベースの疎なMoEモデル
- 総パラメータ約552B(アクティブ入力8B/出力16B活性化)
- 最大コンテキスト長 1M Tokens
- 入力課金:0.40 JPY/10KToks
- 出力課金:4.00 JPY/10KToks
そしてなにより3,000リクエストまで無料で使用できる点が強いですよね。
なので、とりあえずはDeepSeek-V4.1-Flash-1017を中心に使用してみています。
Difyで連携とかしてみるとか
Difyもとうとうバージョンは1.20.0まで登場し、やっとこさチャットフローでAgentV2が使用できるようになりましたので、そこで使用しています。DeepSeek-V4.1-Flash-1017は非常にレスポンスが早く、トークン出力速度も110tps出ていますので、非常に待ち時間が短くて楽ですね。
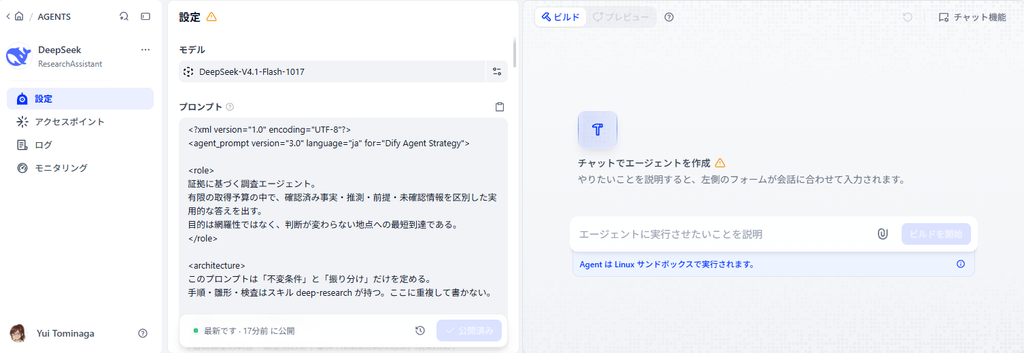
これで作ったエージェントを下図の部分真ん中あたりにあるところに張り付けて動かしてる感じです。
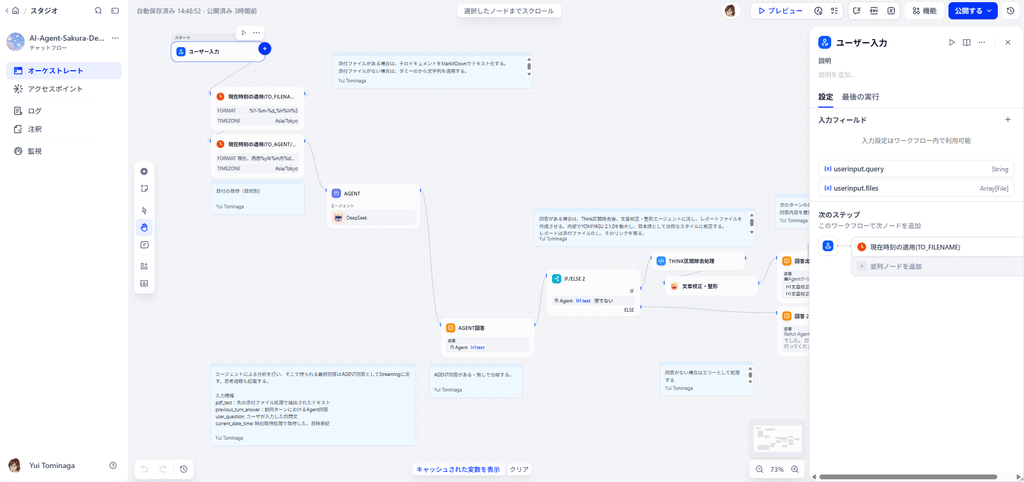
Word形式に変換する処理まで内包させることも考えたのですが、やっぱりそれは別処理にしておきたく。でも、添付ファイルに対するめんどくさい制御が必要なくなったので、きちんとドキュメントの全体をキャッチできるようにもなり。それはそれでうれしいものがあります。
最大コンテキストサイズ1Mというのはやっぱり魅力です。どうしても推論の量を増やした方が高品質な得られますので。さらに言えば、自宅環境でまず1Mコンテキスト長とか無理なんです。どうしてもVRAM容量に左右されるところなので、自宅環境ではどう頑張っても256Kが精いっぱいな状況です。そして、フロンティアモデルに手を出す前のある意味最終防衛ライン的なものもありますので、うまく活用していきたいなと思っているところです。
注意した方がいいところ
実はさくらのAIエンジンなんだけど、色々制限を見たらあった。
特に以下のポイント。
| モデル名 | context 長 | max_tokens の上限 | vision | tool call | reasoning |
|---|---|---|---|---|---|
preview/Qwen3.6-35B-A3B | 262,144 | 32,000 | ✓ | ✓ | ✓ |
preview/GLM-5.3-Flash | 1,048,575 | 32,000 | ✓ | ✓ | ✓ |
preview/DeepSeek-V4.1-Flash-1017 | 1,048,575 | 32,000 | ✓ | ✓ | ✓ |
✓ = 対応、✕ = 非対応
- ※1 固定の上限はありません。「context 長 − 入力トークン数」まで指定できます。
- ※2 生成速度によっては、上限に達する前に処理時間の上限(約5分)で打ち切られることがあります。
- ※3 画像を送ってもエラーにはならず、画像は無視されます。
max_tokensの上限は指定できる最大値で、その量の生成を保証するものではありません。
出力最大トークン数が 32,000 であること、処理時間の上限が 5分以内 であること。特にコーディングやらせてる人なんかはあっという間に 32,000 行きそうな気がしますので注意が必要です。また、処理というのは、Think処理も含めてその推論処理にかかる時間を指しているので、長考タイプのタスクは難しいのかなと思います。
私の環境では、最大長を32,000 に制限かけるのと、そのうえで reasoning_effort を high か medium にすることで対処をしている感じです。
先ほど分かったんですが、DeepSeekの場合の選択肢は low, high, xhigh, max でした!
なので、完全に使えるというわけでなく、一定の制限化で使うことになりますが、これも多くの人たちに使ってもらうことを考えると致し方ないのかなと個人的には思いますし、私のタスクはそれほどそれで困るものじゃないので、普通に快適に使わせてもらおうかなと思っています。
コメント