
vLLMをいい加減触らないとなーと言い出してもう何年経っただろう。気づけばちょっと掠るぐらいしか触ってない。
何ともかっこ悪い話なんだけど、色々知らないことが多すぎるなぁと実際触れてみて感じるばかり。
最終的に固まったConfig
こういう設定で動かしてみることにした。パラメータは後述するとして、XPUとして重要なポイントはハイライトしたところにある。結局の所、xpu-manager というパッケージを用いてデバイスの制御を行うため、NVIDIAのようにGPU Operatorを入れるのではなく、xpu-managerが制御に介在する形をとるらしい。そのため、dri識別子をコンテナ側にも同様に与えてあげることでGPUのパススルーは出来るようだ。
x-vllm-base: &vllm-xpu-base
      image: vllm/vllm-openai-xpu:v0.30.0-x86_64
      ports:
      volumes:
        - /home/********/.cache/huggingface:/root/.cache/huggingface
      environment:
        - HF_TOKEN=${HF_TOKEN}
        - ZES_ENABLE_SYSMAN=1
        - ONEAPI_DEVICE_SELECTOR=level_zero:0
        - CCL_ZE_CACHE_OPEN_IPC_HANDLES=0
        - EnableLEO=0
        - VLLM_XPU_ENABLE_XPU_GRAPH=1
      ipc: host
      command: ["--model",
        "ukisai/Swift-1.5-Qwen3.8-27b-INT4",
        "--no-enable-prefix-caching",
        "--tensor-parallel-size","1",
        "--max_model-len","128k",
        "--max-num-seqs","1",
        "--max-num-batched-tokens","2048",
        "--kv-cache-dtype","fp8",
        "--enable-auto-tool-choice",
        "--tool-call-parser","qwen3_xml",
        "--reasoning-parser","qwen3",
        "--mm-encoder-tp-mode","data",
        "--speculative-config",'{"method":"mtp","num_speculative_tokens":4}']
services:
  vllm-xpu-1:
    <<: *vllm-xpu-base
    ports:
      - "8058:8000"
    devices:
      - /dev/dri/card0:/dev/dri/card0
      - /dev/dri/renderD128:/dev/dri/renderD128
    privileged: true

  prometheus:
    image: prom/prometheus:latest
    extra_hosts:
      - "host.docker.internal:host-gateway"     # allow a direct connection from container to the local machine
    ports:
      - "59090:9090"   # the default port used by Prometheus
    volumes:
      - /home/********/vllm/prometheus.yaml:/etc/prometheus/prometheus.yml # mount Prometheus config file
      - prometheus-storage:/prometheus

  grafana:
    image: grafana/grafana:latest
    depends_on:
      - prometheus
    ports:
      - "23000:3000" # the default port used by Grafana
    volumes:
      - grafana-storage:/var/lib/grafana

volumes:
  grafana-storage:
    name: grafana-storage
  prometheus-storage:
name: prometheus-storagevllmに関する環境変数や設定に対する内容については以下の通り。
| 項目 | 意味 | 値 |
|---|---|---|
| 環境変数 | ||
| HF_TOKEN | HuggingFaceのトークン | ${HF_TOKEN} |
| ZES_ENABLE_SYSMAN | Level Zeroドライバの有効化 | 1 |
| ONEAPI_DEVICE_SELECTOR | どのデバイスにどのレベルの ドライバを適用するか | level_zero:0 |
| CCL_ZE_CACHE_OPEN_IPC_HANDLES | Intel GPU間通信で使用される IPCハンドルのキャッシュ設定 | 0 |
| EnableLEO | OpenCL LEO有効化 | 0 |
| VLLM_XPU_ENABLE_XPU_GRAPH | VLLMにてXPU_Graphを使うかどうか | 1 |
| 引数 | ||
| –model | vLLMで動かすモデル | ukisai/Swift-1.5-Qwen3.8-27b-INT4 |
| –no-enable-prefix-caching | Prefix Caching無効化 | (無効化) |
| –tensor-parallel-size | テンソル並列処理数(複数GPU時のみ) | 1 |
| –max_model-LEN | モデルの最大Context Length | 128k |
| –MAX-num-seqs | 同時実行処理数 | 1 |
| –MAX-num-batched-tokens | 1イテレーションで同時処理する トークン数の最大値 | 2048 |
| –kv-cache-dtype | KVキャッシュのデータ型 | fp8 |
| –enable-auto-tool-choice | tool_call有効化 | (有効化) |
| –tool-call-parser | tool_callで使用するパーサー | qwen3_xml |
| –reasoning-parser | Reasoningモードで使用するパーサー | qwen3 |
| –mm-encoder-tp-MODE | マルチモーダルエンコーダの テンソル並列の最適化方法 | data |
| –specilative-config | MTP機能のための設定 | |
| method | MTP機能で使用するメソッド | mtp |
| num_speculative_tokens | 先読み最大トークン数 | 4 |
設定がちゃんと出来てるかどうかは以下のような所をログで眺めると良く分かります。標準ログに出てきます。
vllm-xpu-1-1  | (APIServer pid=1) INFO 10-01 08:55:50 [api_utils.py:347]
vllm-xpu-1-1  | (APIServer pid=1) INFO 10-01 08:55:50 [api_utils.py:347]        █     █     █▄   ▄█
vllm-xpu-1-1  | (APIServer pid=1) INFO 10-01 08:55:50 [api_utils.py:347]  ▄▄ ▄█ █     █     █ ▀▄▀ █  version 0.30.0
vllm-xpu-1-1  | (APIServer pid=1) INFO 10-01 08:55:50 [api_utils.py:347]   █▄█▀ █     █     █     █  model   ukisai/Swift-1.5-Qwen3.8-27b-INT4
vllm-xpu-1-1  | (APIServer pid=1) INFO 10-01 08:55:50 [api_utils.py:347]    ▀▀  ▀▀▀▀▀ ▀▀▀▀▀ ▀     ▀
vllm-xpu-1-1  | (APIServer pid=1) INFO 10-01 08:55:50 [api_utils.py:347]
vllm-xpu-1-1  | (APIServer pid=1) INFO 10-01 08:55:50 [api_utils.py:286] non-default args: {'model_tag': 'ukisai/Swift-1.5-Qwen3.8-27b-INT4', 'enable_auto_tool_choice': True, 'tool_call_parser': 'qwen3_xml', 'model': 'ukisai/Swift-1.5-Qwen3.8-27b-INT4', 'max_model_len': 128000, 'reasoning_parser': 'qwen3', 'kv_cache_dtype': 'fp8', 'enable_prefix_caching': False, 'mm_encoder_tp_mode': 'data', 'max_num_batched_tokens': 2048, 'max_num_seqs': 1, 'speculative_config': {'method': 'mtp', 'num_speculative_tokens': 4}}
vllm-xpu-1-1  | (APIServer pid=1) INFO 10-01 08:56:18 [model.py:692] Resolved architecture: Qwen3_5ForConditionalGeneration
vllm-xpu-1-1  | (APIServer pid=1) INFO 10-01 08:56:18 [model.py:2030] Using max model len 128000
vllm-xpu-1-1  | (APIServer pid=1) WARNING 10-01 08:56:22 [indexer_topk.py:29] Failed to import the DeepSelect extension (vllm._deepselect_C): No module named 'vllm._deepselect_C'
vllm-xpu-1-1 | (APIServer pid=1) INFO 10-01 08:56:22 [cache.py:343] Using fp8 data type to store kv cache. It reduces the GPU memory footprint and boosts the performance. Meanwhile, it may cause accuracy drop without a proper scaling factor参考情報・注意事項
取り敢えず引数チューニングは重要なんだなということを理解するのに時間がかかった。設定値は以下のサイトを参考にしていますよ。
以下は vllm serve コマンドにおける必要な引数の情報。

こちらは Qwen-3.8-27B に対するレシピサイト。必要事項をポチポチ押すと、その引数の例が出ます。今回使用しているSwift-1.5-Qwen-3.8-27B と言うモデルは、Qwen-3.8-27B をベースにしたLoRAチューニングモデルなので、元モデルと構造が全く同じなのです。
ってか、以下の設定をしないとそもそも tool_call に対応しないとか、Reasoning してくれないとか鬼でしょw
- –enable-auto-tool-choice
- –tool-call-parser
- –reasoning-parser
また、Swift-1.5-Qwen3.8-27b-INT4 は普通にGated Modelであるため、HF_TOKENSは必須になる。.envに環境変数設定をきちんとしておきましょう。
Prefix Cachingは無効化しとく
Prefix Cachingは無効化しています。結局の所、これはPrompt Cachingと同じ意味を持っていて、所謂常にクリーンな状態で推論をさせることにはならないからです。このPrefix Cachingは単独ユーザが使う分には何の問題がないので、私の環境もそうなんですが、こればかりは私の拘りになってしまいます。
ちゃんと以下のようにCache Saltを入れておくのであればこのキャッシュをONにしても大丈夫らしい。
{
  "model": "your-model-name",
  "messages": [
    {"role": "system", "content": "You are a helpful assistant..."}
  ],
  "cache_salt": "tenant_user_12345"  // ← ここにユーザー一意の識別子を入れる
}ちなみにこれを有効にした場合、私の環境ではなんと 96.3 tps と言う脅威のGeneration速度を記録しました。おそろしかぁ・・・
これが発覚したので速度計測はやり直ししてみました。
その後の速度計測等の確認
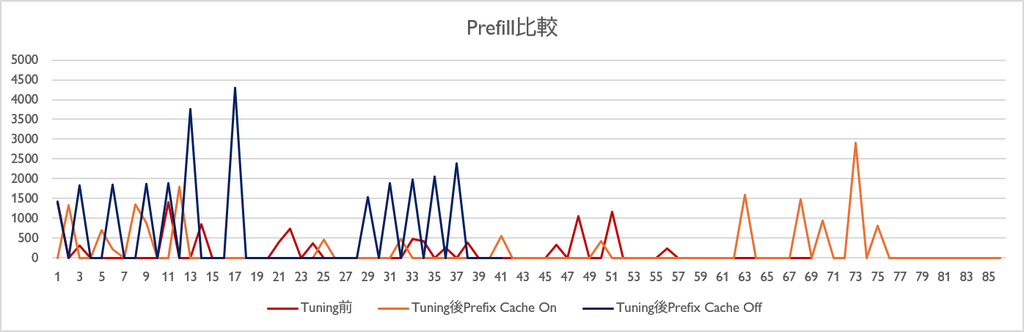
全体的な値としてこうなってます。
Prefill
ログをベースに数値を拾っていく限りでは、以下のような値を記録しました。それなりの長文を取り込んでるかとは思いますが、Prefix Cache Offを削減したからといってそれほど値が変動しない感じで、むしろPrefix Cacheを効かせてる方がタイミングの問題であまり値が取れてなかったようみえちゃいました。
Generate
こちらは比較的明確にTuning前は低く、Tuning後は速く推移してることを確認しました。ただ、Prefix CacheをOnにしてる方は持続的に速度が速いですが、Offにした場合は状況により上下差が大きく出てるようにはみえます。これは、速度向上自体の効果はMTP側ででているものであり、そのAcceptance次第なところがあるのかな?という感じでした。
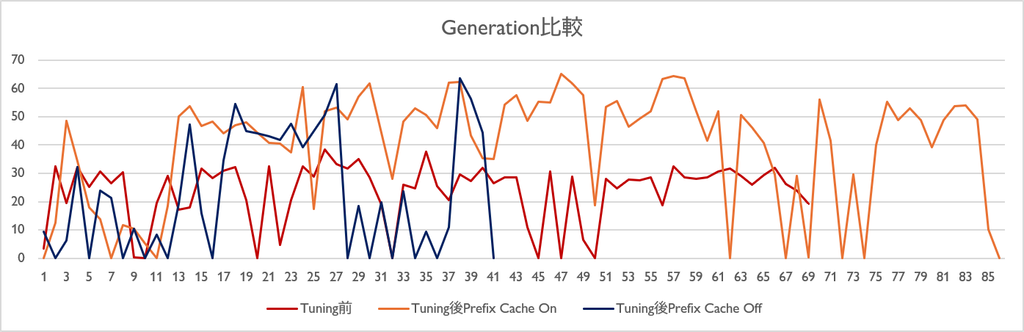
全体のAcceptanceは平均:63.5%、最大:100.0%、最低:36.9%となっていました。
コメント