
きちんと対応付けできるのもあるけど、対応付けできないのもあるらしい。
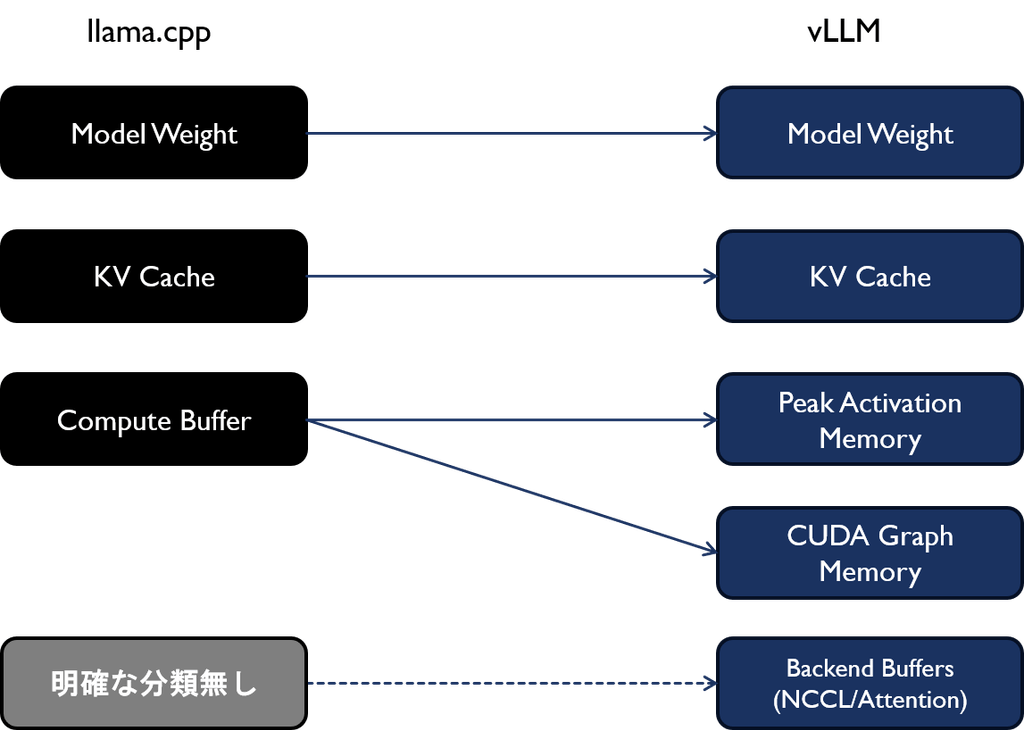
Model Weight及びKV Cacheは既に過去の記事で説明してるとおりなので割愛すると、llama.cppにおいてComputer bufferと呼ばれるものは、その中にPeak Activation MemoryとCUDA Graph Memoryを含むそうだ。
Peak Activation Memoryというのは「中間計算テンソル、最大アクティベーション用の一時メモリ」で、主にこれらがllama.cppにおいてはCompute Bufferとして扱われる訳なんだけど、実はCUDA Graphなんかもllama.cppではこの中に突っ込まれるようだ。
ちなみにIntel XPUの場合は、このCUDA Graphに相当するXPU Graphという仕組みが存在し、そこのバッファリングメモリがちゃんと独立して管理されることになる。
で、Backend Buffersというのは「通信バッファやattention関連の内部計算バッファ」なんだけど、これはllama.cppの中では「何故かエンジン動かした時にVRAM使用量がごく僅かに増えてるのだが・・・となるものを指してるようで、llama.cpp上では明確な括りがないらしい(ほんとかね?)。

2025年にそのあたりでちょぴっとそこについて述べられてるっぽい記述は見つけた。
The backend may need to allocate some additional memory, but it shouldn’t grow significantly between evaluations. If you think that may be a bug, open an bug report with all the necessary details to reproduce the issue.
私自身vLLMに手をつけ始めたのはここ最近になってからなので、まずもってvLLMについては全く詳しくないからこうして勉強してる訳なんだけど、こういうところで色々そのプロダクトの特色ってみえてくるものなんだねって思ったり。
コメント