
これに行ってまいりました。
どちらかと言うと座談会に近いイベントだったのですが、凄く勉強になったというのは、私は殆ど外部LLMをちゃんと(?)使ったことはないんですよね。だから・・
- キャッシュというものの定義がイマイチ良く分からない
- サブスクリプション(定額制)を使用する人達が見る景色が分からない
というのがありまして。それを勉強したかったのが参加した同期なのですが、参加してみるとなるほどと分かったのは以下のようなこと。
彼らの言うキャッシュ=プロンプトキャッシュ
彼らの言うキャッシュが「プロンプトキャッシュ」であることを理解しました。私みたいなオンプレミス思考の人間は、キャッシュと言えば「Key-Valueキャッシュ」「プロンプトキャッシュ」の2つが存在することが分かるんですが、彼らの中で出てくる「キャッシュ」はもろに後者の「プロンプトキャッシュ」です。
KVキャッシュというのは、以下のような因果モデル内において、文字を積むグループを回してる際に直前状態のKey/Value状態をキャッシュ保持することで、後ろに結合される1トークン分の計算だけを行えるようにすることで推論速度を引き上げるものです。
スコープ的には内部処理の細かい所で多用される機能であり、実質学の機能がないとLLMはこんなに流行りませんと言っても過言ではないぐらいに重要な機能です。
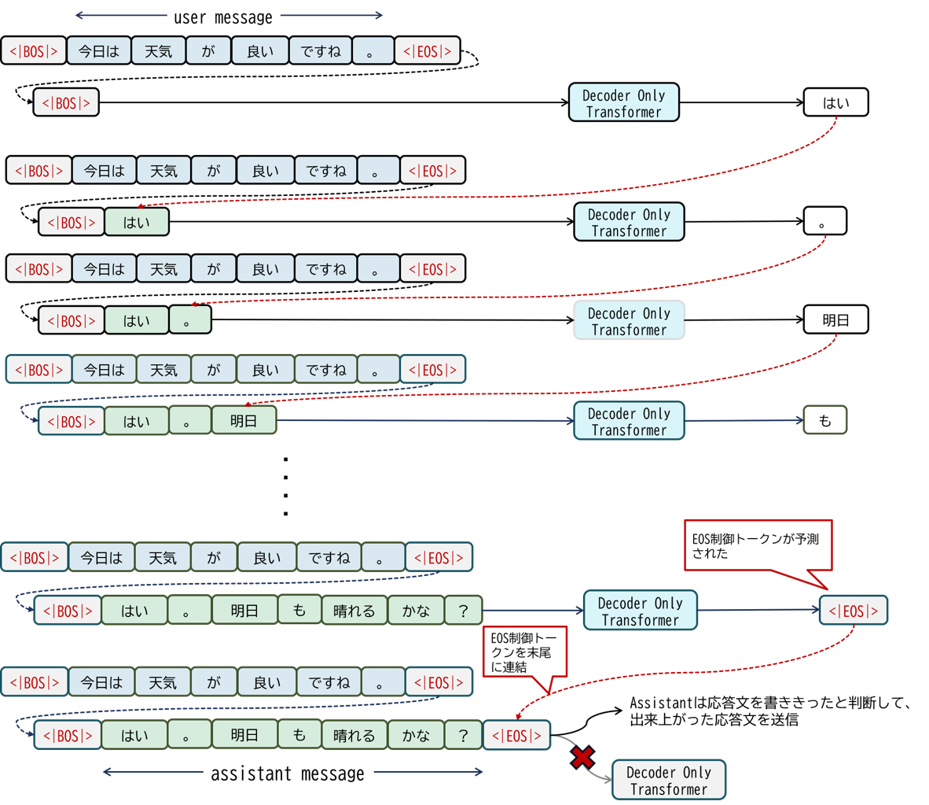
プロンプトキャッシュというのは、それまでのコンテキストそれ自体をキャッシュとして保持する機能で、それらの演算結果をキャッシュとして保持することにより、計算基盤の負荷をしっかり削ろうという代物。新しく入ってくるターン分の演算をするだけで良くなり、応答性能も上がるしたとえば会話履歴の取り込みも比較的安価で済むようになる、所謂レイテンシ最適化の機能として実装されているものです。
| 項目 | KVキャッシュ | プロンプトキャッシュ (prompt caching) |
|---|---|---|
| 本質 | モデル内部の計算最適化 | APIサービス側の機能(課金・レイテンシ最適化) |
| 対象 | 各層・各トークンのアテンション計算で生じるK(key)とV(value)のテンソル | 処理済み入力トークンの計算結果 (サービスが保持する一時キャッシュ) |
| 目的 | 逐次生成で各ステップごとにアテンションを再計算しないこと | 同一先頭(prefix)を持つプロンプトの再処理を省き、遅延とコストを削減すること |
| 再利用範囲 | 1回の推論(セッション)内に限定。推論が終了すると解放 | 複数リクエストにまたがって再利用可能 |
| ユーザーの可視性 | 不可(モデル内部)。 GPUメモリ(VRAM)消費に影響する | 可。 応答のusageに cached_tokens等のフィールドとして返る |
| 課金への影響 | 直接なし | 入力トークン料金の割引 (プロバイダにより異なる) |
| 有効期間 | 推論セッション中のみ | Azureでは非アクティブ後5〜10分でクリアされ、最終利用から1時間以内には必ず削除される |
| 出力内容への影響 | なし(計算結果は等価) | なし。レイテンシとコストの削減のみで、出力内容には影響しない |
私の場合、特にプロンプトキャッシュは外部LLMでも殺しています。その理由は単純に「AIメーカー側に一切の情報を持たせたくない」からなんですが、外部LLMを活用して居る方はこれをかなり気にしていることを知りました。
それは、以下のような事情があるためです。
キャッシュへ書込むにも金がかかる
大きな違いはこれです。ローカルLLMはプロンプトキャッシュがあろうがなかろうが、KVキャッシュがあろうがなかろうが基本的にはコストは変動しません。重要なのはそのGPU/VRAM内にその領域が収まるかどうかだけです。しかし、どうもこのキャッシュに保存する際、そういうサービスにおいてはそこでお金がかかるのだそうです。
さらに厄介なことにキャッシュ保持時間の明確な仕様がない場合がある
プロンプトキャッシュ存在の有無は非常に大きく、キャッシュから引っ張り出せた場合はその読み取りに対するコストは従来の読み取りコストと比べて非常に安価に設定されているんですが、これの生存期間が超過するとキャッシュ情報は破棄されることになるので、コンテキスト全てを頭から全部従来課金ルールに従いトークンを取り込むことになるので、その瞬間いきなり使用量が増大するということで、ここがかなりヒヤッとするポイントらしいです。
| プロバイダ | 最新モデル | TTL(最新) | 1世代前のモデル | TTL(1世代前) |
|---|---|---|---|---|
| OpenAI | GPT-5.6以降(GPT-6系を含む) | 30分(prompt_cache_options.ttl: "30m"、既定かつ唯一の値。直近の書き込み・再利用から30分は再利用可能、それ以上保持される場合もある) | GPT-5.5 / GPT-5.5 Pro | prompt_cache_retention: "24h"(対応値は24hのみ。通常約30分、最大24時間 |
| Anthropic | Claude Fable 5.1 / Opus 5.5 / Sonnet 5.5 / Haiku 5.5 | 既定5分(cache_control: {type: "ephemeral"})。ttl: "1h" で1時間に延長可能(書き込み料はベース入力料の2倍) | Claude Opus 5 / Sonnet 5 / Haiku 4.5 | 最新と同一(既定5分、1時間延長オプションあり)。TTLはモデル非依存で全アクティブモデルが同一仕様 |
| Gemini 4 Argon | 暗黙キャッシュのみ。Interactions APIは明示キャッシュ非対応で、TTLをユーザー指定する項目は公式ドキュメントに明記されていない | Gemini 3.8 Flash / 3.6 Flash / 3.1 Pro Preview(および2.5系) | generateContent APIで明示キャッシュ(キャッシュオブジェクト)を作成可能。TTL未指定時は既定1時間、60分超に延長可能 |
さらにそのキャッシュ保持ルールは公開されてなかったりすることもあれば、モデルによってコロコロ仕様が大幅に変わるという摩訶不思議な特性もあるようで、それによって振り回されてる人も少なくはないようです。こちらも私個人としてははっきり一言「気持ち悪い」に尽きるものがあり、昨今のAIメーカーはだいぶ脳みそがとろけてしまってるんだろうか・・・とさえ思いました。
定額利用する方の見る景色
定額利用する方が見る景色というのはやっぱり私の視野とだいぶ異なっているような感じで、たとえば私の利用形態は完全に従量課金だったりしますので、使った分計上される「加算型」の視点でものを見ます。課金レートの変更とかは発生しますが、基本的に「使ったら増えていく」なので、想定する分の課金レートを設定あるいはそのコストを前払いしながら動かしていくことを考えます。
定額利用の場合、利用枠というものが存在し、どの程度トークンを紡がせたかの割合を見ます。従量課金側であまり見ないのは、「工夫次第で本来よりも大きな利用枠でLLMを使うことができる」という部分です。つまり、たとえば本来の利用枠を100%と仮定します。通常ですと、その利用枠は100%から動くことは本来ありません。
しかし、50%程使い切ってるところで、何かの理由で「利用枠リセット」というイベントが発生し、それまでの使用量が0に戻り、再び100%使える状況になると、それはつまりその月は全体で150%の利用が出来るということになります。
昨今X.comを中心に「利用枠リセット」で狂喜乱舞されてる方の姿を見かけるのはこれのことのようで、確かにそれが起きた+かなり利用枠を使ってしまってる状況下でこれが発生すると嬉しい事態になるのは間違いありません。だって、通常と比較して1.5倍もの仕事を行わせることが出来るんだもの。特にLLMに対するリクエストって、現在においてはコーディングのような物作り系のタスク、人の仕事を代替するようなタスクが多く、それはそのまま作業効率に直結しますから。
精神的にこうした動きというのは凄くエキサイティングだろうなーとすぐに想像しました。実際そうした方の中で、AIプロバイダ側が恐らくリセットを賭けるだろうと読みを行ってそれが当ったときはそれこそ「ドーパミンがいーっっっっっっっぱいでる」って表現されてたように、多幸感MAXなのは言うまでもないことだと思います。
彼らがこれを行うのは
- 需給調整のため
- 解約防止のため
- 収益化(課金体系の移行等)
- 競争のマーケティング
と言うところにその意図があるようです。
私は駆け引き苦手なので(;´Д`)
じゃぁ、私はやるか?やらないです・・・と言うか私というのはデスね・・・
- 宝くじあたったことない
- 麻雀やると100発100中ビリっけつで枕を涙で濡らす側
- パチンコを生涯で一度だけやったとき、3分で5,000円が溶けた
と言うぐらいにギャンブルが苦手、駆け引きが苦手なのです。なので、私の嫁様は株ぐらいはやりますけれども、私はそれすら行っておらず、会社員時代の持株会で持ってた株は全部嫁様のものになってもらってます。私自身は壊滅的なぐらいにダメなのです・・・
なので、このように金額見積もりを難しくすることが起きること自体、なかなか辛いものがあるし、多分これをエキサイティングにこなしていく人というのは、もしかしたらギャンブル適性があるのかもしれません。(もちろんそれは私から見れば羨ましき側面なのです)
その他色々あったこと
この勉強会では、実験目的ということでお一人分リモート枠が設けられていました。そこに収まったのはなんと神奈川の人でして、たまたまconnpassを見てこの勉強会に目がとまり、出席なさってたとのこと。話してみたらリモートにもかかわらず積極的に発言なさってて、結構このイベント自体も盛り上がりました。
懇親会はここ最近では初めて私も出席してみました。近くのビル内にあるイタリアンレストランだったのですが、そこで出てくるニョッコフリットがメチャクチャ(゚д゚)ウマーでした。その中で、4人ワイワイ語らう中私もしっかり参加させてもらったんですが、とにかく熱量が凄かった。聞いてて凄く楽しかったです。
ただ、ここ最近ではなかなか経験のない ワインとシャンパンとハイボール のちゃんぽんを経験しまして、今でもちょっぴり胸焼けはしておりますが、はい、私は元気です。
この日の出会いに、ただただ感謝です。次も行けそうなら行きたい!と思っているマス。
コメント