
LLMが実世界に干渉するとき、何が必要か?
LLMは現在、人間の作業の一部を肩代わりするぐらいに実行力を持ち、様々なところで活躍をしています。しかし、思い出してほしいのですが、当初我々の目の前に登場したChatGPTなどは、あくまでチャットボットのような存在であり、出力はあくまでテキストであり、私たちの実世界に干渉するような能力は併せ持ってなかったように思います。
しかし、いつの間にか実世界に干渉できる能力を持ち、スケジューラへの登録、GitHub へのプルリクエストの投与、下手すれば外部サイトにご迷惑をかけてしまったり、といった行為をしてしまうことも増えました。そもそも実世界に干渉できる能力とはどのようなものなのでしょうか。
実は、LLMが出来ることは今日も変わっていません。基本的に計画・判断を担うLLMが出力として出せるのは「テキスト」形式に限られています。どんなに計画・判断能力が向上しようと、実世界に対してその行動を行使するには、別途あるものが必要になります。
それがインタフェースです。
インタフェースとは
たとえば、チャットボットの場合、人間がテキストで質問などを入力し、LLMがそれを受け取って何らかの処理をし、応答としてテキストを出力します。このテキスト入力を受け付け、LLMに引き渡して、その応答を受け取ってユーザに対してテキストを出力する、これも1つのインタフェースです。
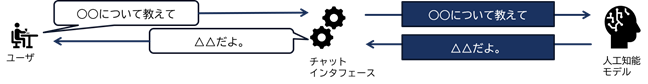
図 1 チャットインタフェースとLLMの関係
インタフェースは「何かを受け取って」「何かを返す」ということしかしません。しかし、それでもLLMはそのインタフェースを活用する形でユーザの要求に応え、何らかの応答を返すことでその存在を世界に知らしめるぐらいの効果はもたらしてきたわけです。それが所謂初期のChatGPT等に代表される2022年~2023年前半に登場したLLMおよびチャットインタフェースです。
LLMは「頼る」事を学ぶ
2023年6月13日にOpenAIがモデルに対して1つ新しいことを学ばせました。それがFunction Callingです。そして、これを進化させ、AIエージェント連携の礎として登場させた機能が2023年11月に生まれた Tools(Tool Calling)です。これは、モデル応答にある特殊な回答をさせるよう学習させた機能で、この機能は大手各社が積極的に追従していきました。結果、オープンウェイトモデル含めて、様々なモデルがこれを可能にしています。
これはどんな機能かというと、「LLMが自身で処理を行うのではなく、外部の何かに処理を委託する機能」です。それまでLLM自身が何でも引き受けて処理することを是としていましたが、たとえば外部から情報を仕入れたり、外部のツールを動かすために「このようなツールを動かしてみてはどうか?」と外部ツールを動かす「提案」をすることで、外のツールと連携して自身では行えない処理を肩代わりしてもらうというものです。
たとえば、LLMは自身では手に負えない処理を要求された場合に、以下のような応答を応答文中に含めます。このとき、通常メッセージを含めるセクション messages とは異なるセクションでその委託内容を出力します。
| { “role”: “assistant”, “tool_calls”: [ { “id”: “call_abc123”, “type”: “function”, “function”: { “name”: “get_weather”, “arguments”: {“city”: “Tokyo”} } } ] } |
これを受け取ったインタフェースはもし自身に get_weather と言うツールが予め仕込まれている場合、そのAPIにこの値を投入し、最新の天気情報を取得してきます。そして、その応答してきたAPIを連携して出た結果は、チャットインタフェース側で以下のように情報をまとめ、人工知能モデルへの応答という形で返します。
| { “role”: “tool”, “tool_call_id”: “call_abc123”, “content”: “18度、晴れ” } |
じゃぁ、この辺りのツールは誰が仕込むの?と言う話になりますが、それは当然人がインタフェース機能の中に仕込むことになります。
全体の流れを図に表すと以下のようになります。
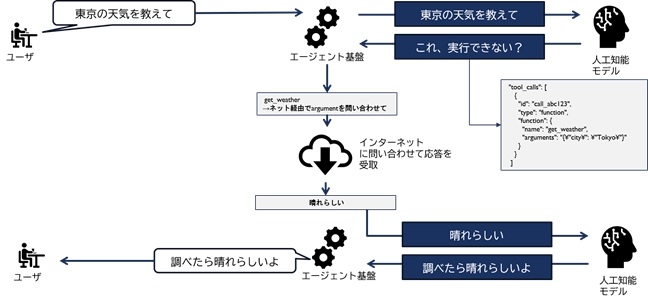
図 2 エージェント基盤とLLMの関係
よって、こうした tool_call の仕組みが正常に機能するかどうかは、モデルと使用しているインタフェースがきちんとかみ合ってるかどうかによって大きく左右されます。実際、Tool_Callingの仕様はたとえば大手ですとそのベンダーによって名称もそのAPI仕様も大きく異なります。
Tool Callingループ構造
Tool Callingを発展させてできたのが、Tool Callingループ構造で、AIエージェントとしての基礎的な作りになっています。
このエージェント環境構成は、ちょうど頭脳であるLLMに、具体的に何かを実行するための運動機能を付与するような行為に近いです。そして、LLM内部の思考とプロンプトで予め与えられた指示内容に従い、その目的がはたされるまで
- エージェント基盤から可能な限り必要な情報を受け取る
- プロンプトで与えられた情報に従い、求めるものをLLMが書き出す
- ゴールへたどり着くために外部の力を借りたい場合は tool_call を実行して、エージェント基盤にその実行を依頼する
- エージェント基盤はその実行を受取り、実行する。結果応答はLLMへおくる
- 基盤側から送られた情報をLLMは読み取りそれを踏まえた思考をする
- 最終回答が出たらユーザに返すが、まだ必要な事項があれば3に戻る
ということを繰り返していきます図に表すと以下のような形になります。
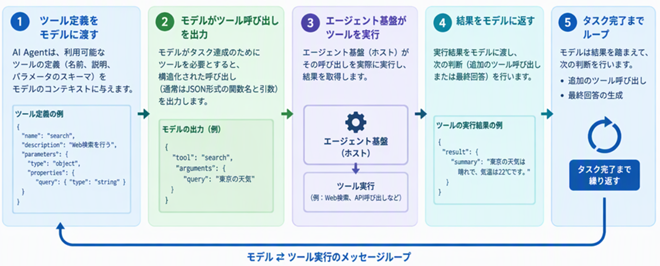
図 3 Tool Calling ループの全体像
LLMは何を学習しているか?
LLMはそのtool_callを特に以下の内容について学習しています。
- 構文(フォーマット)
- tool_callを繰り出す際のJSONフォーマットが正しく送出できるか?
- 調べたい内容をJSONフォーマットにキレイに載せられるか?
- 1ターンの判断
- ツールは実行して貰えたか?正常に応答は返ってきたか?
- 得られた結果は及第点となり得るか?それとも追加での調査が必要となるか?
学習方法としては、主にSFTが使用されます。特に構文が崩れてしまうと環境側がきちんとその要求を受け付けられませんので、特に強く学習したのではないかと考えられます。
そうしたtool_call学習が為されているかどうかがAIエージェントとして動作する最低限の要件となります。
つまりモデル側は、tool_call を正しく繰り出し、返ってきた応答を読んで次の判断をする、という最低限の振る舞いを学習しました。 しかしこの学習は、基盤側が要求を受け取り、実行し、結果を返してこそ初めて意味を成します。 モデル側が要件を満たしたところで、基盤側の設計が応えなければ実世界への干渉は成立しません。 その基盤側で何が起きたかを、次に述べます。
ハーネスエンジニアリング-基盤側の成熟
インタフェースの標準化(MCP)
前節で、Tool Calling の仕様はベンダーごとに名称も API も大きく異なると述べました。
この断片性を解消したのが 2024年11月25日に Anthropic が公開した Model Context Protocol(MCP)です。
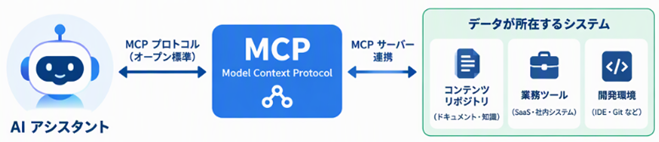
図 4 AIアシスタントとMCP、実世界との関係図
MCP は、AI アシスタントをデータが所在するシステム(コンテンツリポジトリ、業務ツール、開発環境)へ接続するオープン標準規格です。その後 Google が 2025年4月にこの標準を受け入れ、Microsoft も Agent Framework で MCP サーバー連携を公式にサポートしています。
モデル側が「頼り方」を学習したのと同じ時期に、基盤側は「頼られ方」を標準化しました。この2つが噛み合ったことで、ツール連携はベンダー固有の仕様を越えて複製可能なものになりました。
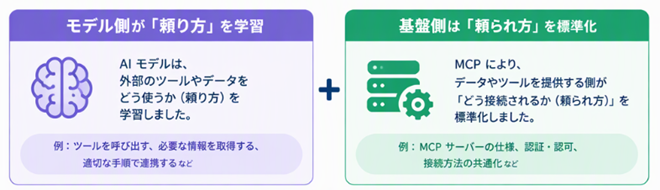
図 5 MCPと言うものがもたらしたもの
能力のモジュール化(Agent Skills)
Anthropic が 2025年10月16日に紹介し、2025年12月18日にオープン標準として公開したのが Agent Skills です。
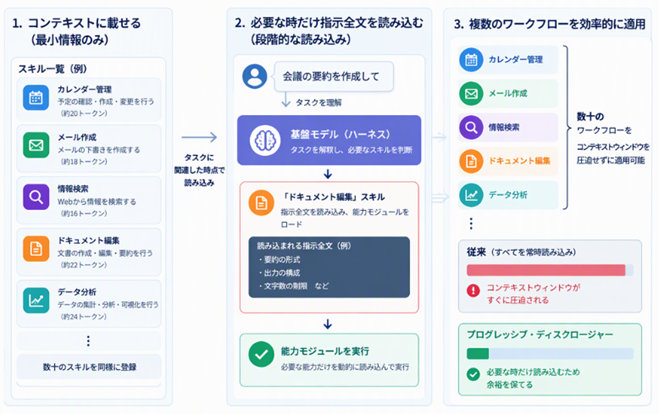
図 6 Agent Skillsの仕組み
スキルは、名前と説明だけ(数十トークン)をコンテキストに載せ、そのタスクが関連づいた時点で初めて指示全文が読み込まれます。このプログレッシブ・ディスクロージャーにより、数十のワークフローをコンテキストウィンドウを圧迫することなく 適用できます。
ここで注意したいのは、Skills はハーネスそのものではなく、ハーネスが段階的に読み込む能力モジュールだということです。基盤が「いつ、どの能力を身体に読み込むか」を決定する。この決定こそが基盤側の設計です。
ループ制御と権限の設計
現行の Coding Agent で人気を博した仕組みの中核は、能力のモジュール化そのものではありません。
いつ停止するか、どのツールを許すか、どの操作に人間の承認を要求するか、何を実行したかをどう記録するか、をシステム側が定める設計です。
これをループエンジニアリング(ハーネスエンジニアリング)と呼びます。コーディング領域で先に成熟したのは、ファイル・シェル・git・テストという環境が、検証可能なフィードバックを安く提供するためだと考えられます。
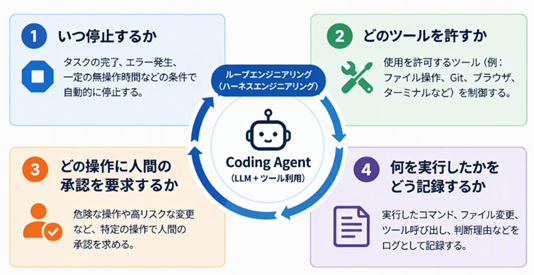
図 7 ループエンジニアリング
なお、干渉の成立には能力だけでなく制御が必要です。
実世界に干渉するエージェントは、意図しない操作(誤削除・重複送信・不正アクセス)を起こし得ます。MCP サーバーを足す際には、何のデータを外部へ渡すかをレビューし、信頼できる事業者のサーバーを選ぶことが公式に推奨されています。
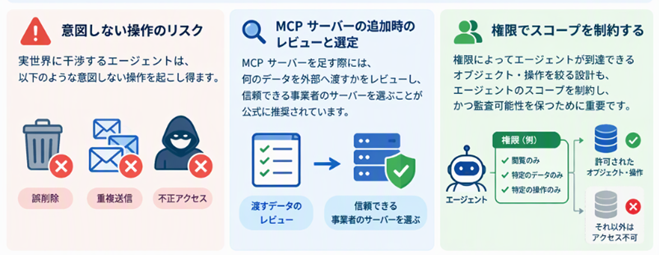
図 8 権限と制御の必要性
権限によってエージェントが到達できるオブジェクト・操作を絞る設計も、エージェントのスコープを制約し、かつ監査可能性を保つために重要だとされています。ハーネスは運動器であると同時に、ブレーキと記録装置でもあるということです。
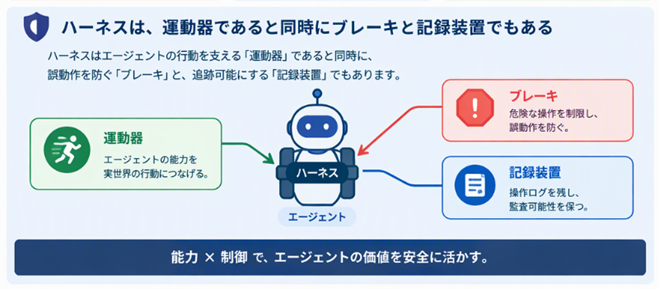
図 9 ハーネスというものの役割と意義
LLMが実世界への干渉を行うには-LLMを「知性」たらしめるもの
ここまでの内容をまとめてみると、LLMが実世界へ干渉するにはtool_call学習と、エージェント基盤の整備という2つが不可欠であると言えるでしょう。
モデルと基盤の双方が進展してこそ、LLMは実世界へ干渉可能になるのです。
LLMには元来、脳に匹敵する処理能力があります。
2022〜2023年のチャットボット運用では人間が身体を持たずに言葉を出力するだけででしたが、インターフェースを身体として構築しモデルへのアクセスを実現してこそ、知性が表出したのではないでしょうか。
知性を形作る決定的条件は、モデルの計画が実世界で検証される点にあります。
モデルが計画を立てツールを実行すると、実世界からの応答を受けて計画を修正します。この応答はモデルの予想に沿わず、ファイル書き込みやテスト実行の結果は成功か失敗かの事実を返します。
実世界はモデルの思い込みを容認しません。ツール実行結果が得られなければ検証は完結しませんし、知性はモデル内部だけで完結しないということです。
知性とは、計画・干渉・応答確認・修正のサイクルを閉じ、実世界と連動して回せる時点で初めて表れるものなのかなというのが、現時点での私の結論です。
実世界への作用は取り消しのできない結果を生むため責任が伴います。
基盤は権限管理、承認フロー、可逆性、記録機能を備える必要があります。出力回路と結果責任の設計が共に整ってこそ、LLMは単なる予測機械から知性へと進化できると言えるでしょう。
コメント