llama.cpp

Artificial Intelligence

勉強会なるものに行ってきたよ!

オフサイトで勉強会に行くのは何年ぶりだろうかこれに行ってきましたです。開発者視点のローカルLLMはどう見えてるのか?と言うのが気になりました。福岡でも有名なエンジニアさんであるきしだ(@kis)さんが主宰されており、会場は博多駅から近いLI...
Artificial Intelligence

RTX3060とGemma-4-12b

GeForce RTX 3060は意外にやる子過日、まさかの3万YEN切る価格で入手したRTX 3060ですが、実は以前会社員時代に最初に会社で購入したGPUでもあります。2022年当時の相場だとおよそ80,000JPYでしたね。このころは...
Artificial Intelligence

論文翻訳品質確認をしてみたよ。

Hy-MT2-1.8Bの実力を測ってみたTencentが公開した中で、軽量モデルであるHy-MT2-1.8Bについて評価をしてみました。Tencentは中国企業の中でもかなり初期段階からDeepLearningの画像系処理でもろもろ取り組ん...
Artificial Intelligence

AIとの向き合い方は人それぞれ+ご挨拶

時々X.comを見てみると初めまして。ゆういと申します。今や気づけばいろんな人がAIと向き合ってああでもない、こうでもないとか、中にはAPI型こそ至高!いやいや、ローカルLLMこそ究極!なんぞおいしんぼならぬAIんぼみたいな展開になってると...
Artificial Intelligence

Hermes Agentなるものに触れてみたよ

最近いろいろささやかれてる中で、Hermes Agentというツールがあり、要はここ最近登場してるClaudeCodeだったり、Codexだったりーなものに似たようなものってざっくり理解してるのだけど、これを投入してみたなど。冒頭文を日本語...
Artificial Intelligence

override-tensorで、指定した層だけをCPUにオフロードする手法

うちのブログをご覧になってくださる人からフィードバックが!なかなか書きっぱなしでフィードバックが返ってこない私のこのブログなんですけれども、有難いことにX.comでディープラーニングモデルのことを色々リサーチなさってるきしださん(が当ブログ...
Artificial Intelligence

Dify/llama.cppの利用は盲目的にはできない件

llama.cppの心得:同時接続数に気を付けようEmbeddingモデルを使う際、私はローカルSLMをよく利用します。理由は「レイテンシーが低いから」の1点に尽きます。API型LLMで実行する場合に比べて恐ろしく処理が速くなるんですね。ま...
Hardware

CPUを交換したよ

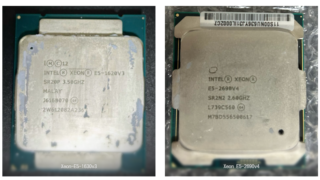
本日CPUを交換しました。左は既存であったIntel Xeon E5-1630v3、右は新しく載せ替えたIntel Xeon E5-2690v4です。ヤフオク!さんにて、なんと5,000円でXeon E5-2690v4を購入しました。新品当...
Artificial Intelligence

RTX3050で何ができるか?

安価なGPUでできることを模索してみる昨今Xを眺めていると、えらく高価なGPUでローカルLLMをぶん回してる話題がたくさん飛び交ってます。やれ、DGX-Spark(当初60万→現在100万ぐらい?)だの、RTX5080(20万円前後)だの、...
Artificial Intelligence

環境構築:古いワークステーション仕入れました

PRIMERGY TX140S1には荷が重すぎたため、ひとまずつなぎとしてワークステーションを一台追加することにしました。今回追加したのは往年の名機(?)HP Z440です。本体メモリは8GBのECC Registered DDR4メモリを...